Claude Fable 5.2 来了:更快还降价了,但官方却说多数人先别换
11 月 9 日,Anthropic 发布了自家最顶级模型的新版本 Claude Fable 5.2,顺带还发布了一个同底座的兄弟型号 Mythos 5.2。消息一出,AI 圈讨论得挺热:输出速度比上一代快了最多 30%,API 价格还降了两成,输入每百万 token 8 美元、输出 40 美元。可有意思的是,Anthropic 自己在公告里补了一句:多数编码和知识型任务,建议先从 Opus 5.5 开始。
新旗舰发布,官方却劝你先别换。这篇就把三件事讲清楚:Fable 5.2 到底新在哪,谁能用上,以及你到底该不该换。
先弄清:Fable 和 Mythos 其实是同一个模型
这次发布最容易让人晕的,就是一下子冒出两个名字。先说结论:Fable 5.2 和 Mythos 5.2 用的是同一套底层模型,差别只在门禁。
Fable 5.2 加装了网络安全和生物滥用方面的防护,所以能开放给所有用户。Mythos 5.2 拿掉了其中一部分防护,只发给通过网络安全验证项目或生命科学验证项目的机构,说白了就是给做防御性安全研究和生命科学研究的组织准备的。普通人完全不用管 Mythos,记住 Fable 5.2 这一个名字就够了。
模型名字里的 Fable 是 Anthropic 给最顶级系列起的新名头。往下依次是 Opus 5.5、Sonnet 5.5、Haiku 5.5,分别对应重活、日常主力、轻量快活。这个排位后面还会用到,选模型的时候心里先有个谱。
这次到底变了什么:三处实在的变化
先看速度。Anthropic 说,Fable 5.2 的输出速度比 5.1 快了最多 30%。写长代码、跑长任务的时候,这个差距是能感觉到的。另外还多了一个 fast mode(快速模式),生成速度能再提 2.5 倍,不过价格也要翻倍,输入输出分别是每百万 token 16 美元和 80 美元。
再看价格。标准 API 定价从 5.1 的输入 10 美元、输出 50 美元,降到了输入 8 美元、输出 40 美元,降幅两成。按官方说法,这是给开发者省成本。但先别急着算省了多少钱,后面有个坑要单独讲。
最后是能力。按 Anthropic 公布的数字,编程 Agent 测试 FrontierCode 2.0 上,Fable 5.2 在最高推理强度下拿到 49.1%,上一代 5.1 是 32.4%,Opus 5.5 是 45.5%,OpenAI 的 GPT-6 Astra 是 42.8%。VentureBeat 统计,15 项公布的评测里新模型领先了 13 项。不过也有掉链子的地方:知识工作测试 GDPval-AA 上,Fable 5.2 的 Elo 评分 1831,反而低于 Opus 5.5 的 1866。
| 项目 | Fable 5.2 | Fable 5.1 | Opus 5.5 |
|---|---|---|---|
| 输出速度 | 比 5.1 快最多 30% | 基准 | — |
| API 价格(输入/输出,每百万 token) | 8 美元 / 40 美元 | 10 美元 / 50 美元 | — |
| FrontierCode 2.0(最高推理强度) | 49.1% | 32.4% | 45.5% |
| 上下文窗口 | 100 万 token | — | — |
官方还讲了两个挺能说明问题的例子:一是 1000 个运行 Fable 5.2 早期版本的智能体,用 28.7 小时复现了费马大定理的形式化证明;二是 Anthropic 说,合入自家核心代码库的改动里,超过 90% 由 Claude 写出,还用它把一个关键生产服务从 Python 迁移到了 Rust,新服务启动速度大约是原来的 26 倍。这些都是官方说法,听着厉害,但要记得:上面所有跑分都是 Anthropic 自己公布的,目前还没有独立第三方的验证。
谁能用、怎么开:先对一下你的账号
Fable 5.2 发布当天就上线了,但不是人人都能点开。免费版用户用不上它,得是付费方案、API 或者 Claude Code 才能用。
具体分三种情况,对号入座就行:
- Claude 网页和 App 的付费用户:在模型选择器里就能看到 Fable 5.2,直接点选。Pro 用户注意一个时间点:11 月 16 日之前,11 月 9 日之前就开始付费的老用户可以用每周上限的 50% 来跑 Fable,算是个尝鲜窗口,过期就按正常额度算。
- Claude Code 用户:把 Claude Code 升级到 2.1.321 或更新版本,就能在里面选 Fable 5.2。低于这个版本是看不到的,先升级再找。
- API 开发者:模型名是 claude-fable-5-2,AWS、Google Cloud、Azure 也同步上了,按量计费。
还有一句得说在前头:Claude 官网不对中国大陆开放注册,这篇写给已经有账号的读者,讲的是怎么选、怎么用。如果你还没有账号,别去信网上来路不明的代充和共享账号,那种号封起来连带着你的对话记录一起没。
别被“降价”骗了:真正决定账单的是推理强度
价格降了两成,听着是好事,但账单可不只看单价。Fable 5.2 这类模型有个推理强度档位,同一个编程任务,强度不同,花的钱能差出将近 6 倍。
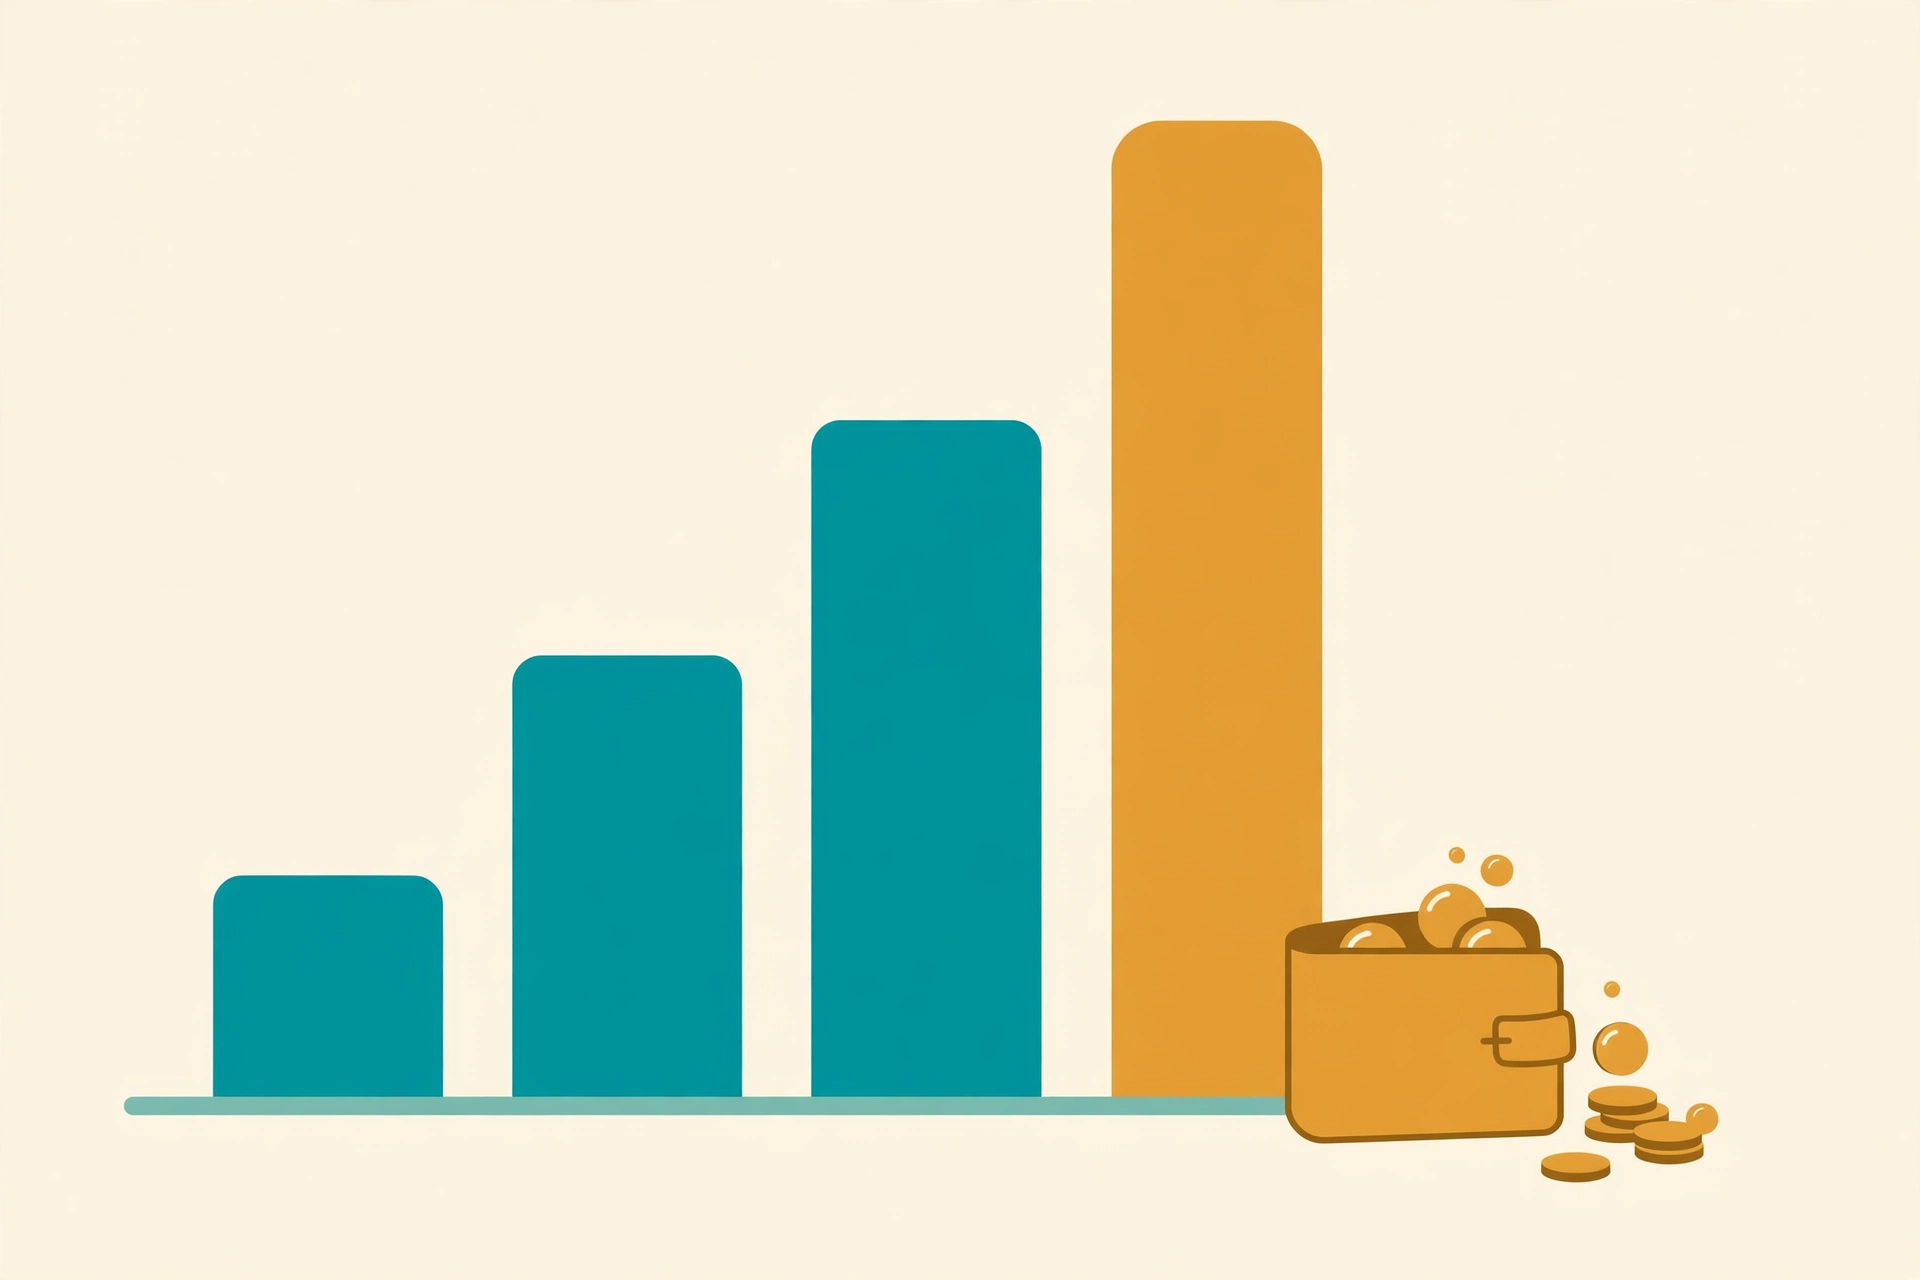
按 Anthropic 公布的测试数据,同一个任务,推理强度开到 Medium 时平均花 2.48 美元,High 是 6.72 美元,Xhigh 是 14.19 美元,开到最高的 Max 是 44.70 美元。更扎心的是,Max 的分数反而比 Xhigh 低,45.7% 对 49.1%,等于多花了钱、效果还倒退了。API 默认用的是 High 档。
所以省钱的办法不是盯着单价降了多少,而是别把强度开过头:日常任务先用默认档,碰上确实难啃的长任务再往上加一档;加到 Xhigh 还搞不定的,先想想是不是任务拆得不够细,别直接开 Max 烧钱。企业用户也一样,单价降 20% 不等于账单降 20%,真实成本得按任务量乘上强度档位来算。
该换谁不该换:一张表说清楚
官方那句“多数任务先用 Opus 5.5”其实已经把答案说了一半。结合这次发布的信息,可以按用途这样分:
| 你是谁、干什么 | 建议 | 理由 |
|---|---|---|
| 写代码、做长任务、跑多智能体 | 试 Fable 5.2 | 编程测试上领先 Opus 5.5,速度也更快,长任务收益最大 |
| 日常聊天、写东西、改稿子、做分析 | 继续用 Opus 5.5 | 知识工作评分反而更高,官方也推荐从它开始 |
| 图快图便宜、处理轻量活 | Sonnet 5.5 或 Haiku 5.5 | 杀鸡不用牛刀,旗舰模型跑小任务纯属浪费 |
| API 开发者、按量付费 | 先拿真实任务测一轮 | 单价降了,但强度档位一开高,账单可能比以前还贵 |
| 免费版用户 | 不用纠结 | 这次更新跟你没关系,等官方放开再说 |
一句话总结:靠它吃饭的人(写代码、跑 Agent)值得第一时间试;只拿它聊天写字的人,换不换区别不大,Opus 5.5 够用了。
三步上手:先试一周再决定
如果你符合“值得试”的那类,也别急着把默认模型全换掉,照下面三步来:
第一步,先确认入口。打开 Claude,在模型选择器里找到 Fable 5.2;用 Claude Code 的先升级到 2.1.321 以上。Pro 用户记得 11 月 16 日之前有 50% 上限的尝鲜窗口,过期恢复正常。
第二步,拿真实任务对比。别拿“你好”这种问题试,挑一个你上周真实做过的任务,比如一段要重构的代码、一个多步骤的调研,让 Fable 5.2 和 Opus 5.5 各跑一遍,看结果质量和用时差多少。只看跑分没用,自己手里的活才是标准。
第三步,试一周再定。如果一周下来,Fable 5.2 确实让你少返工、少等,那就换;如果感觉差不多,就留在 Opus 5.5,把额度省下来。模型没有信仰,只有账本。
还有几件官方没细说的事
最后补几个容易忽略的点:Pro 用户那个 50% 上限的尝鲜窗口只到 11 月 16 日,之后按正常额度算;Mythos 5.2 和普通人没关系,看到也不用研究;API 的 fast mode 速度翻 2.5 倍但价格也翻倍,赶时间才开。
另外再提醒一句:这篇文章里引用的所有跑分和成本数字,都来自 Anthropic 自己的公告和系统卡,第三方还没来得及复测。价格和额度规则以官网最新说明为准,订阅前先看一眼,别凭印象下单。
Fable 5.2 是实打实的升级,但升级不等于人人都要换。先看自己是哪类用户,再决定要不要为它多花那份心思和预算。