AI视频终于能拍"长片"了:从1分钟到10分钟,普通人现在就能用的3个长视频玩法
10月13日,OpenAI 公布了一个让视频圈直接炸锅的案例:AI 视频生成平台 Higgsfield 接入 GPT-6 Astra 之后,AI 生成视频的时长上限从原来的约 1 分钟,一口气拉到了 10 分钟以上。
Higgsfield 自己已经把这套流程用在了自家 YouTube 频道上——那个频道有将近 50 万订阅,团队靠这套工作流做出了超过 10 分钟的教学视频,而以前同样的活儿要花大量人工去拍去剪。
先说清楚两件事,免得你白激动:第一,这是 Higgsfield 内部的工作流突破,官方还没说什么时候向所有用户开放、也没公布价格;第二,GPT-6 Astra 目前主要在 ChatGPT 的 Work 和 Codex 里给付费用户用,免费版用不上。所以这篇文章分两半:前半讲这次突破到底厉害在哪,后半讲不用等官方、你今天就能用的长视频玩法。
这次突破,到底突破了什么
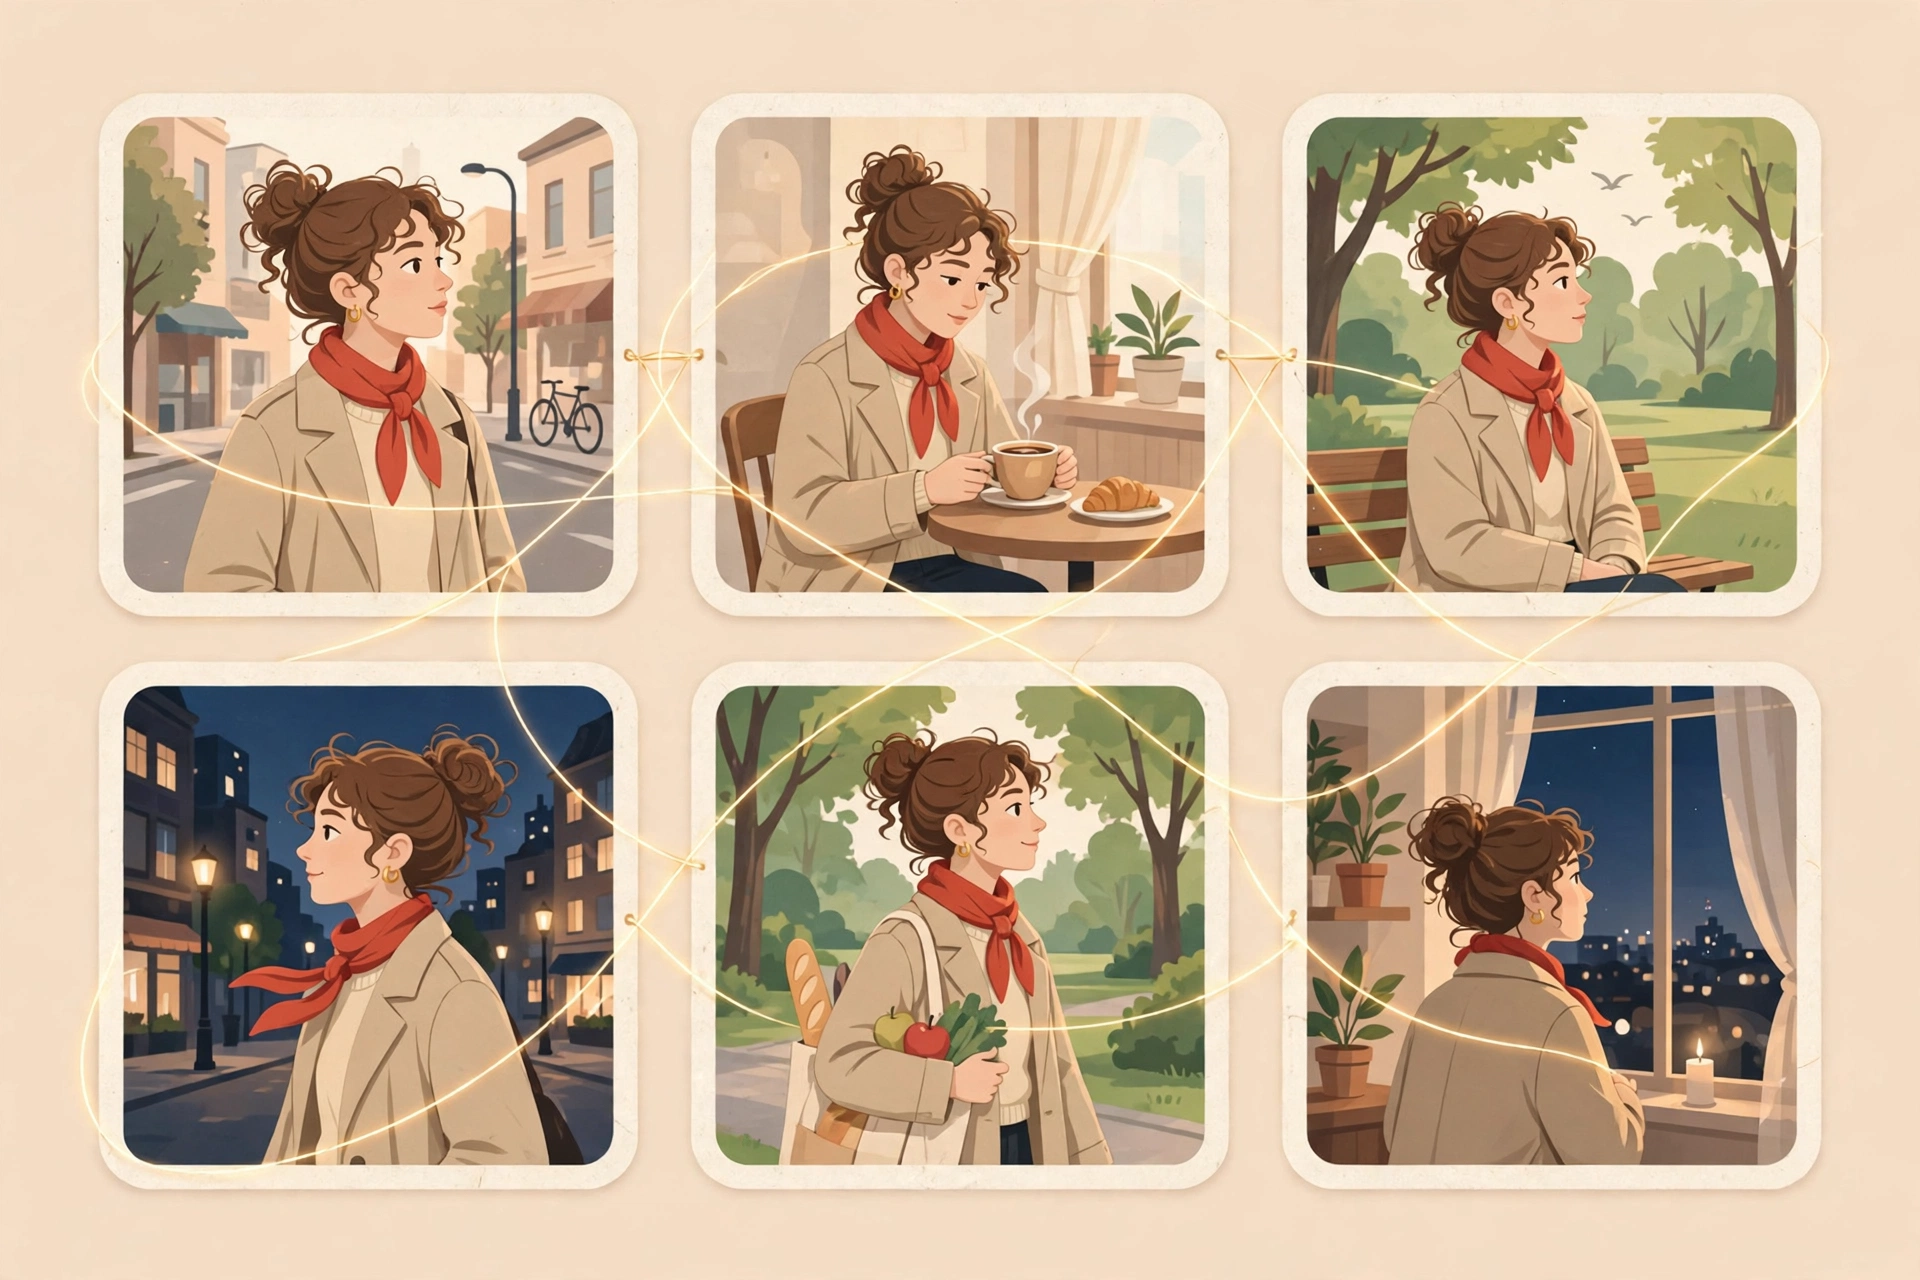
很多人以为 AI 做长视频难在"算力不够",其实不是。真正的坎叫一致性:第 1 秒出现的人物,到第 300 秒还得是同一个人、同一件衣服、同一个场景风格。以前的模型生成 1 分钟视频都经常"变脸"——主角前一秒长发、后一秒变短发,咖啡杯凭空消失又出现。时间越长,崩的概率越高,这就是为什么各家都卡在 1 分钟左右。
Higgsfield 这次的解法不是"让模型一次吐出 10 分钟",而是换了个思路:让 GPT-6 Astra 驱动一群创意智能体,像真正的制片团队一样分工——有的智能体负责出分镜的备选方案,有的负责处理重复性制作活,遇到 3D 建模这种复杂工作,Astra 还能直接调用外部工具去干。说白了,AI 从"一个画画的"升级成了"一个会用人、会用工具的导演组",一致性问题就被工作流兜住了。
顺带提一句,Higgsfield 还在用 GPT-Image-2.5 做宣传图——那模型能在图里稳定渲染可读的文字和信息图,小生意做海报、做产品介绍图能省不少钱。以及他们透露的下一步:基于 GPT-Live-1 做"语音到视频",就是你对着麦克风描述想法,AI 实时生成视频。不过那还是未来,先别当真。
对普通人来说,这意味着什么
先泼个冷水再讲机会。冷水是:10 分钟 AI 视频不等于 10 分钟好视频。Higgsfield 的 CEO 自己也说了,长视频的企划、审核、品牌调性把关这些活儿一个都省不掉,AI 只是把"拍出来"的成本打下来了。
机会是实打实的:以前你想做一条 5 分钟的产品讲解视频、一条课程试看、一条店铺宣传片,要么自己拍剪好几天,要么花钱找外包。现在"分段生成 + 拼接"这条路已经跑通,意味着一个人、一台电脑、一个晚上,真能攒出一条像样的长视频。这对做知识付费、做小生意、做自媒体的人来说,是生产工具级别的变化。
不用等官方:现在就能用的 3 个长视频玩法
下面这三个玩法,用的都是今天已经能注册、能用的工具,不用等 Higgsfield 开放。
玩法一:分镜脚本 + 分段生成 + 剪映拼接(最推荐)
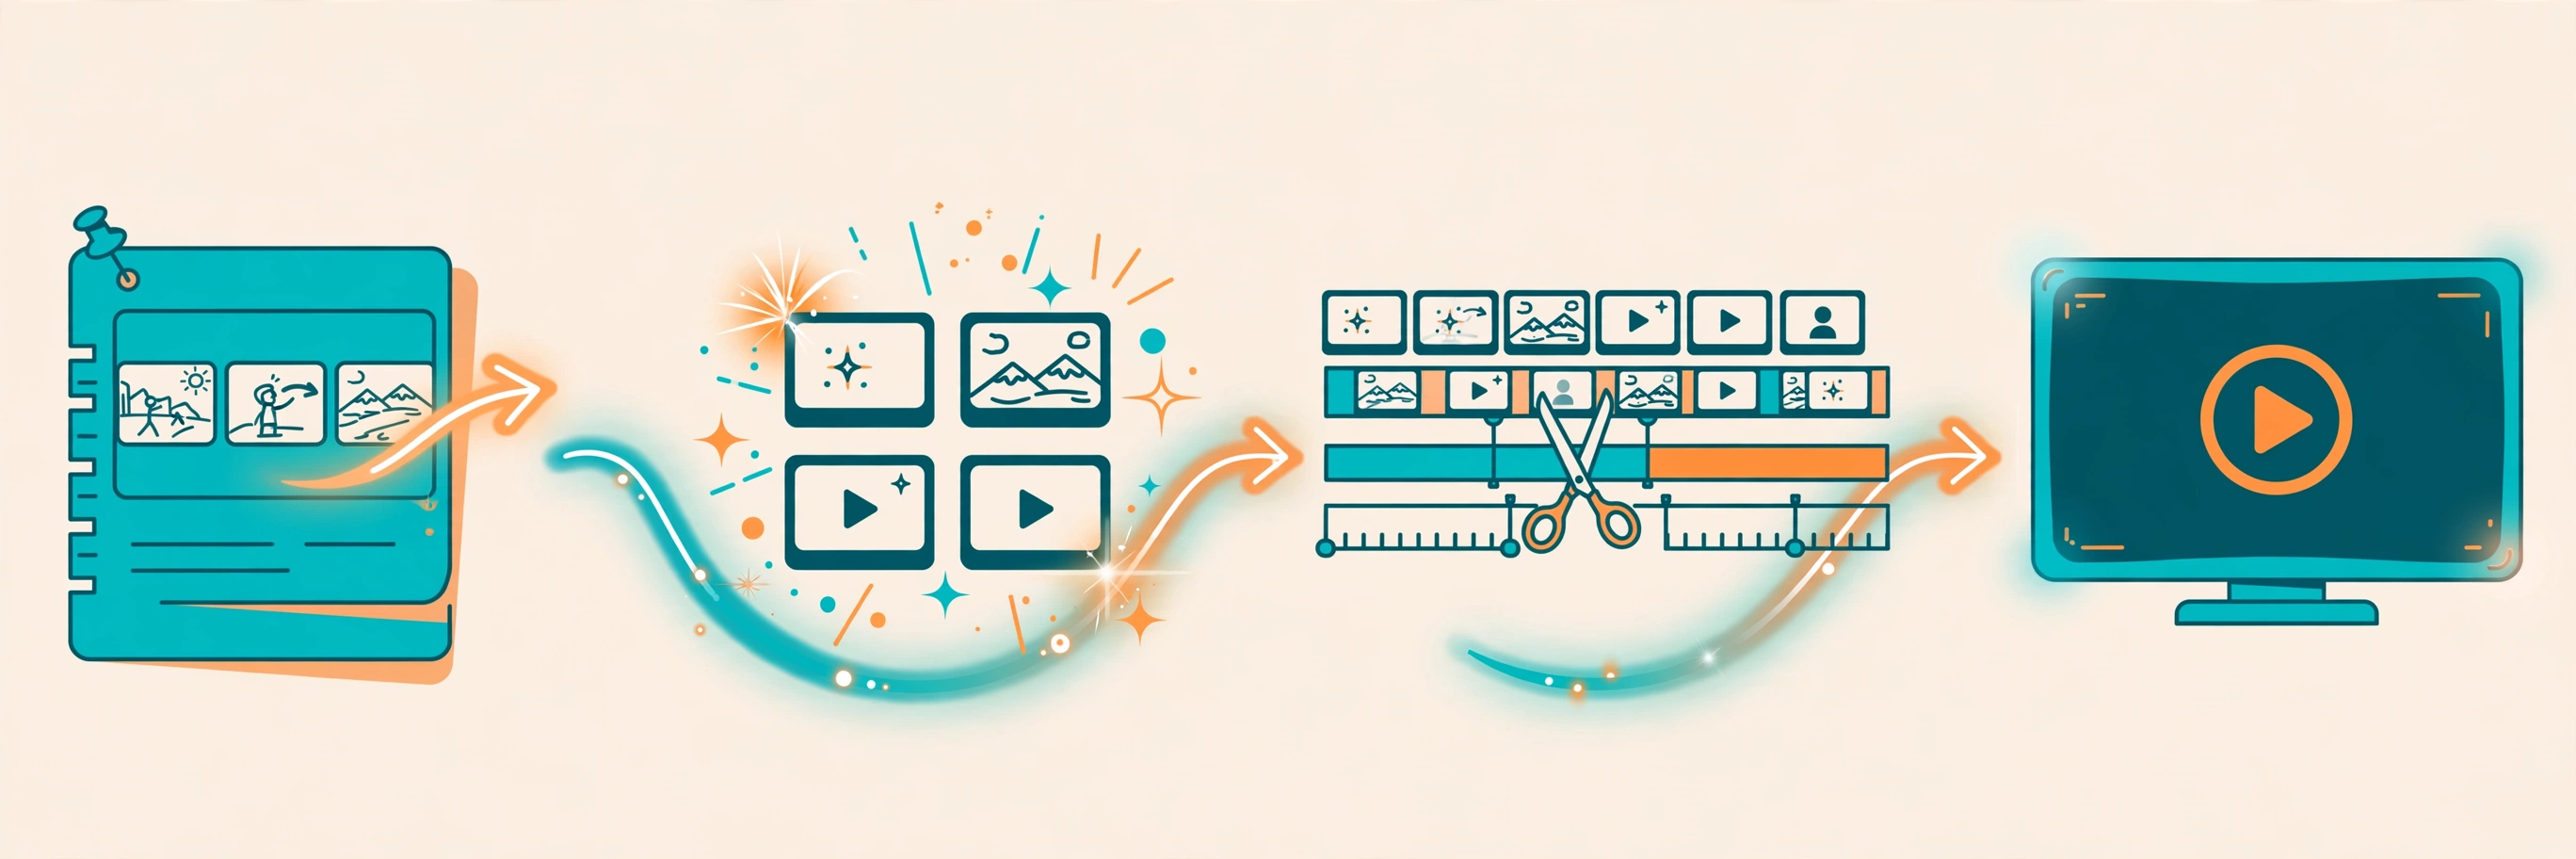
这是目前最稳的"土办法",也是 Higgsfield 工作流的平民版。核心就一句话:别指望 AI 一次生成 10 分钟,把 10 分钟拆成 20 个 30 秒,一段一段生成再拼起来。
具体步骤:
- 第一步,写分镜脚本。先把 10 分钟拆成 15-20 个镜头,每个镜头一句话:场景+人物动作+镜头运动。比如"镜头3:女生走进咖啡馆,推门,镜头跟随"。可以直接让 ChatGPT/Claude 帮你扩写成分镜表。
- 第二步,锁死角色。这是最关键的一步。用 Nano Banana 或 GPT-Image 先生成一张主角定妆照,之后每个分镜都把这张图作为参考图喂给视频模型(Vidu Q4 支持最多 15 张参考图,可灵、即梦也都有参考生视频功能)。人物、服装、画风三个要素在提示词里每个分镜都重复写一遍,别偷懒。
- 第三步,分段生成。每个分镜单独生成 10-20 秒。别贪长,短片段的一致性最好控制。生成时固定随机种子(有这选项的平台一定要用),能省一半返工。
- 第四步,剪映里拼接。片段之间加 0.5 秒的交叉叠化转场,统一调个滤镜,再配上 AI 配音(HeyGen 或剪映自带的文本朗读都行)。转场和统一调色是"藏拙"神器,能把接缝处的不一致糊过去。
这套流程我建议你先拿 2-3 分钟练手,跑顺了再加长。熟练之后,一条 5 分钟口播讲解视频,一个晚上真能做出来。
玩法二:关键帧先行,画面质量翻倍
直接文生视频,画面容易"放飞自我"。改进办法是:先用图像模型把每个分镜的关键帧画出来,确认没问题了,再拿关键帧去做图生视频。
操作很简单:用 Nano Banana 2.1(支持 4K 和多轮改图)按分镜一张张出图,人物不对就多轮修改同一张,直到满意;然后把定稿的关键帧喂给 Vidu、可灵或即梦做图生视频。图生视频的一致性天生比文生视频好,因为起点就是一张确定的图。这招特别适合产品展示、剧情类短片。
玩法三:口播/数字人长视频,信息密度最高
如果你要做的长视频主要是"讲东西"——课程、产品介绍、知识分享,别跟画面死磕。用 HeyGen 这类数字人工具(10 月 12 日那篇讲过):上传一张照片或选个数字人形象,把长文案喂进去,一次生成几分钟的口播视频,再分段拼起来。
这类视频观众要的是信息,不是电影质感,数字人口播完全够用。配上 PPT 翻页、关键帧插图,观感就上去了。这是目前投入产出比最高的长视频形态。
什么人适合现在玩,什么人再等等
| 人群 | 建议 |
|---|---|
| 做知识付费、线上课程的人 | 现在就玩。课程试看、知识点讲解是最适合 AI 长视频的场景,观众容忍度高,回报直接。 |
| 小生意店主(餐饮、美业、电商) | 现在就玩。产品介绍、店铺宣传片用"玩法二+玩法三"组合,成本比找外包低一个数量级。 |
| 想做剧情短片、短剧的创作者 | 先小步试。人物一致性还是最大难题,建议先做 2-3 分钟短片验证流程,别一上来就搞 10 分钟。 |
| 只想尝鲜、没明确用途的人 | 等等。Higgsfield 的完整工作流还没开放,等它真正上线、价格明朗了再玩不迟,现在先收藏这篇。 |
三个坑,别踩
坑一:肖像和版权。用真人照片做参考图、做数字人,必须是本人或拿到授权;背景音乐别随手拿流行歌,用平台自带的版权音乐库。AI 生成不等于可以随便用。
坑二:AI 味太重的运镜。那种慢悠悠 360 度旋转、莫名其妙的推拉镜头,一看就是 AI 做的,观众 3 秒就划走。多用固定机位 + 人物动作,少用炫技运镜。
坑三:把官方宣传当成现货。Higgsfield 这次是 OpenAI 官方博客讲的"客户案例",没给技术指标、没给开放时间表。在它真正开放之前,所有"10 分钟"的讨论都是期货。做决策、做投入计划,别按期货下注。
最后说一句大实话:AI 视频从 1 分钟到 10 分钟,真正的意义不是"能做更长的视频了",而是长视频的制作权第一次交到了普通人手里。以前拍 10 分钟片子是团队的事,现在是一个人加一台电脑的事。工具会越来越便宜,流程会越来越傻瓜,唯一稀缺的东西还是老样子——你到底想讲个什么故事。先把故事想明白,再开工。